迁移 PDF 转换功能
理解项目分层,将原型中的 PDF 转换接口和前端组件迁移到 Saavo。
上一篇已经让 Saavo 项目在本地运行,并完成品牌配置。这一篇将经过验证的原型功能迁移进来。
迁移原型功能
文案和主题全部修改后,接下来就是将我们在原型开发中实现的功能逐步迁移到新项目中。整个迁移的过程还是比较麻烦的,我前面也说了,最好还是人工负责,不过大部分也可以借助 AI 的能力来完成。
要完成功能迁移,首先需要了解当前框架的核心层级划分,你要知道在哪里添加新的代码最合适。
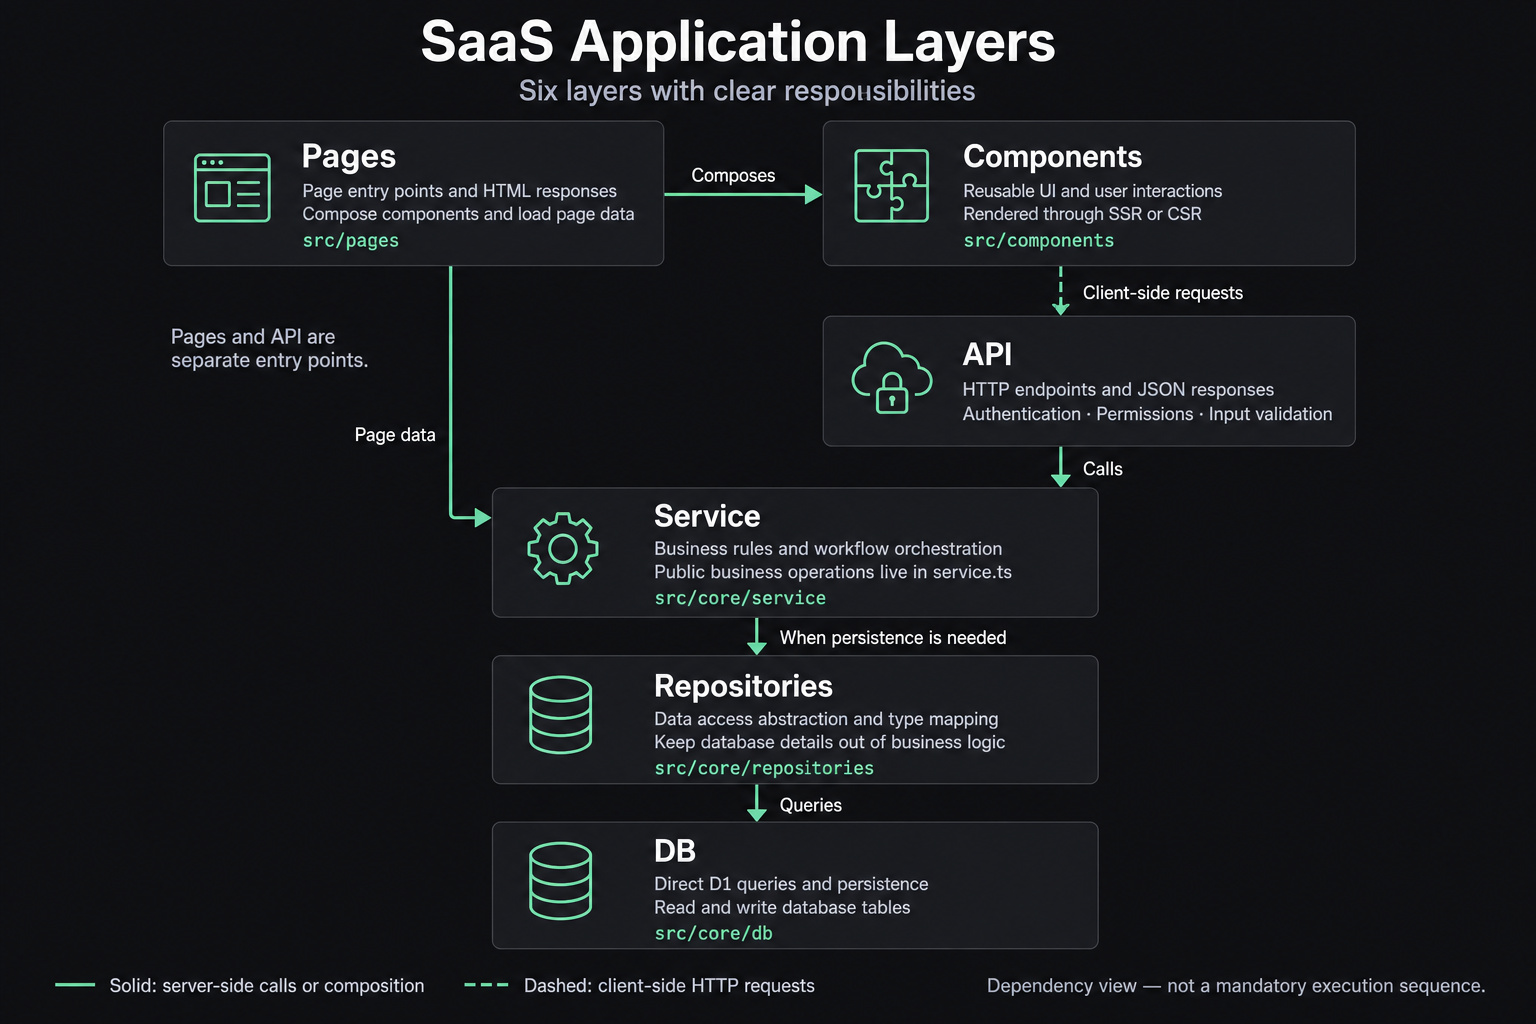
当前的项目是按照传统的分层架构进行划分的:
- DB 层。
DB 层负责 Cloudflare D1 数据库的直接读写,目录在 src\core\db,整体来说该目录下的文件是按照业务进行划分的,每个文件夹对应一种业务模块,代码非常简单,就是直接读写 D1 数据库的表。
大部分情况下,你不需要去手动改动它们,在实现新的业务查询的时候,可以让 AI 帮你增加对应的接口和查询函数即可。
- Repositories 层。
Repositories 层负责类型转换和持久化操作等功能,内部核心逻辑直接调用 DB 层来完成,目录在 src\core\repositories,这一层的代码结构和 DB 层级基本上一一对应,就是对 D1 数据库接口的简单封装,核心主要是负责类型转换。
- Service 层。
Service 层负责业务逻辑的实现,目录在 src\core\services,这一层的代码同样是按照业务划分,在程序中负责对外提供业务接口服务,大多数的业务核心逻辑都在此文件夹下。
对外的接口一般被放在对应目录中的 service.ts 文件中,例如 src\core\services\pdf\service.ts 文件中,就是负责 PDF 转换业务的接口实现。
- API 层。
API 层负责对外提供 HTTP 接口,并根据请求返回对应的 JSON 数据。这一层本身不包含太多复杂逻辑,主要负责请求认证、权限校验、参数校验、调用业务逻辑、整理返回数据,以及生成最终的 HTTP 响应。
- Pages 层。
Pages 层负责页面渲染,目录在 src\pages,这一层的代码最直观,简化理解你可以认为一个文件对应一个页面的渲染。
同样是按照业务划分,在程序中负责对外提供页面渲染服务,根据不同的业务需求,会调用不同的组件来完成页面渲染。
对外的页面一般被放在对应目录中的 page.tsx 文件中,例如 src\pages\pdf\page.tsx 文件中,就是负责 PDF 转换业务的页面渲染。它的内部会调用 Components 层提供的组件来渲染页面。
该层也是直接对外提供 HTTP 服务,和 API 层的主要差别是返回的响应类型不同,API 层返回的主要是 json 数据,而 Pages 层返回的主要是 HTML 页面。
- Components 层。
Components 层主要存放页面组件,目录位于 src/components。这一层通常按照页面或具体功能进行划分,方便不同页面按需组合和复用。
这些组件一般由 Pages 层引入,并通过 SSR 或 CSR 的方式完成渲染,最终展示给用户。当前框架的分层结构已经确定,接下来就可以开始考虑如何把原型中的功能逐步迁移到正式项目中。
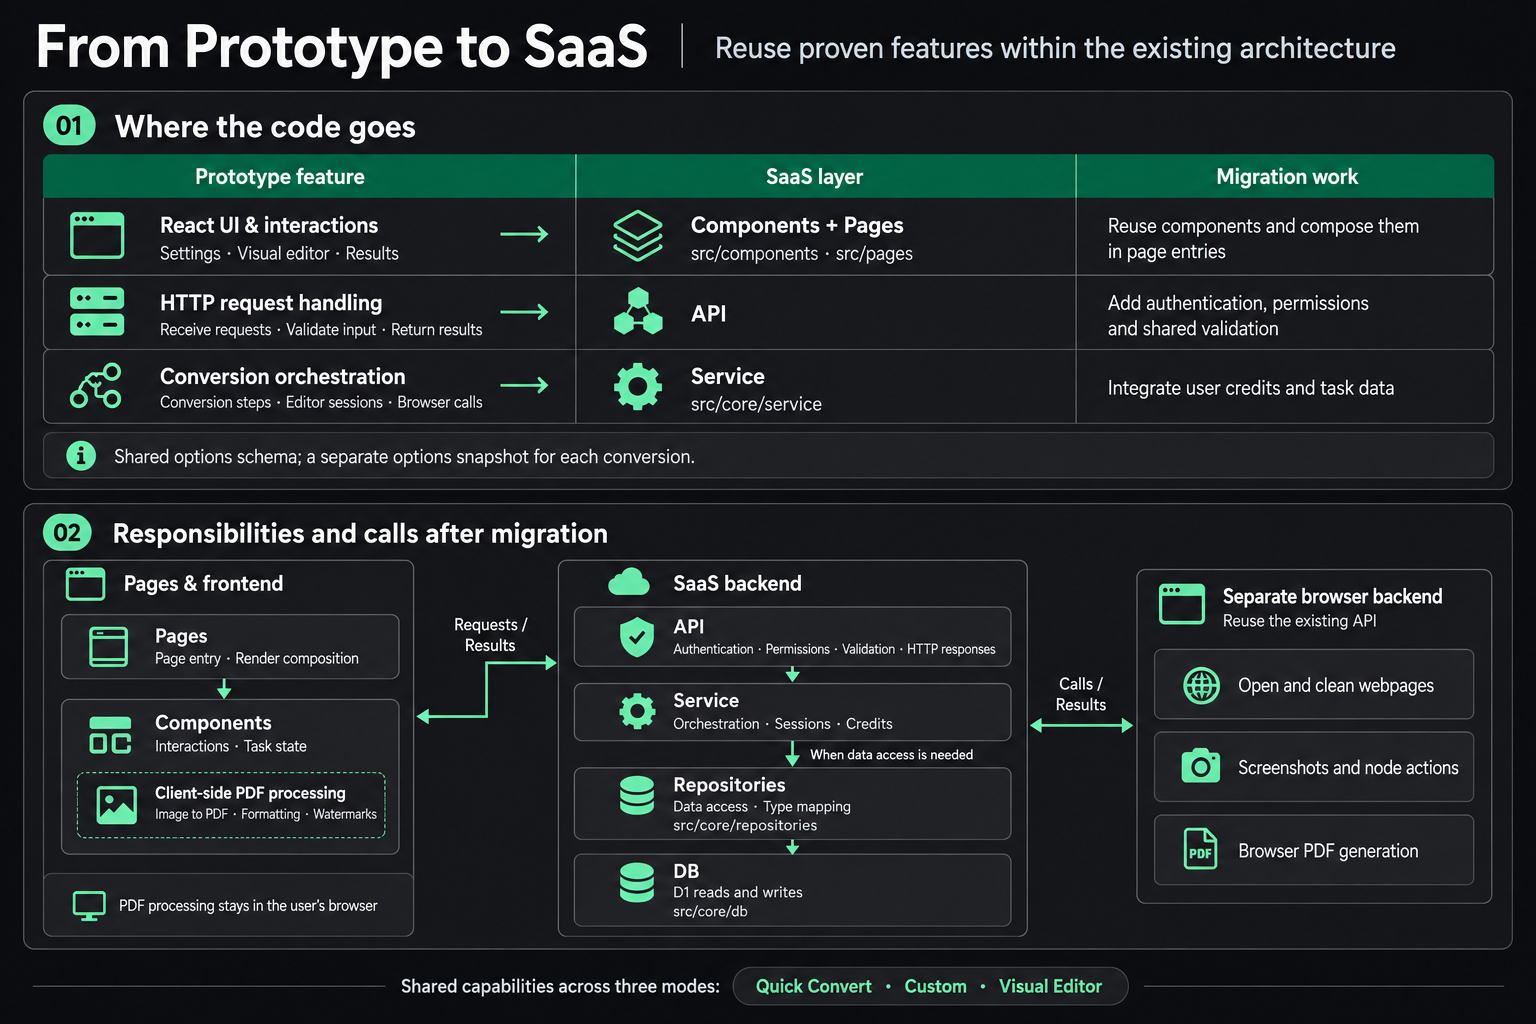
页面部分相对简单。可以先把原型中的 React 组件迁移到 Components 层,再由首页引入这些组件完成页面渲染,直接让 Codex 处理即可。
真正需要重点处理的是 PDF 转换服务。我们需要在 API 层定义对应的路由接口,用来支持三种不同的 PDF 转换方式。用户在前端点击转换按钮后,前端直接调用这些接口,并根据后端返回的数据更新页面状态。
API 层则主要负责请求认证、权限校验、参数校验和响应处理,具体的 PDF 转换逻辑则放到 Service 层中实现,Service 层通过 Repositories 层访问 DB 层的接口来完成业务逻辑。
迁移后端接口
我们可以简单地将迁移工作分为前端和后端。前端先不动,先把后端接口迁移完毕,这样对于测试后端接口也更加方便。让 AI 分析目前的原型项目的所有后端接口有哪些:
| 类型 | 接口 | 功能 | 返回方式 |
|---|---|---|---|
| 快速 / 自定义转换 | POST /api/convert | 生成截图或源 PDF | 流式 NDJSON |
| 可视化编辑 | POST /api/visual/sessions | 创建编辑会话 | 流式 NDJSON |
| 可视化编辑 | POST /api/visual/sessions/:sessionId/actions | 执行编辑操作 | JSON |
| 可视化编辑 | POST /api/visual/sessions/:sessionId/generate | 生成源 PDF | JSON |
| 可视化编辑 | DELETE /api/visual/sessions/:sessionId | 关闭会话并结算额度 | JSON |
可以逐步让 AI 迁移这些接口,每次迁移后都要记得审查边界,避免出现逻辑混乱或者功能遗漏的情况。
我的实现策略是先迁移 POST /api/convert 接口,不要直接让 AI 这样做,应该让它分步执行,这样可以避免代码混乱,一次性迁移太多代码容易导致问题,也不利于人工 review。
下面是我执行的迁移步骤:
- 迁移外部依赖,因为我专门创建了一个独立 Worker 程序负责 PDF 的核心创建工作,所以这里需要先迁移这一部分,它是独立的,毕竟只是 RPC 调用,没有太多复杂的逻辑。
- 根据旧版项目中的代码逻辑,创建 PDF 服务,包括接口定义、业务逻辑和单元测试。
- 创建 API 对外接口,内部调用 PDF 服务来完成业务逻辑。
让 AI 分步迁移后,我对每一步都进行了检查。说实话,生成的代码不算理想,但确实能用,不符合要求的部分我又让它重新做了。除此之外,还可以让它编写测试客户端,用真实场景检查 API 接口是否存在问题。
PDF 转换接口会在服务端打开用户提交的网址,因此不能只在前端检查输入。后端至少要限制为公开的 HTTP/HTTPS 地址,并在每次跳转后重新检查目标地址,拒绝访问 localhost、内网地址和链路本地地址。同时还要限制页面加载时间、跳转次数、生成文件大小和并发任务数,避免一个请求长时间占用资源。
生成后的 PDF 也不能使用任何人都能猜到的固定地址。下载接口需要检查任务归属,临时文件则要设置清理时间。这些限制都属于转换服务本身,部署之前就应该在本地验证完成。
迁移前端组件
前端组件的迁移相对简单,因为它们都是 React 组件,可以直接迁移到 Components 层中。迁移过程中让 AI 自行处理即可,大部分问题不大,主要注意样式合并,以及一些旧的组件是否移除清理的问题。
除此之外,原型中的字体依赖了第三方服务,我让 AI 直接把它们迁移到本地。这些字体并不是网站 UI 使用的字体,而是生成 PDF 时可能会用到,毕竟并非所有 PDF 都只包含英文。
除了这些,还需要让 AI 处理一下移动端适配的问题,前期原型我对这方面没有做任何处理,在移动端下的 UI 惨不忍睹,所以还是需要修正一下。
剩下的就是功能复原和调优,以及样式调整,这部分相对简单,主要是细心测试,发现问题告诉 AI 解决即可。
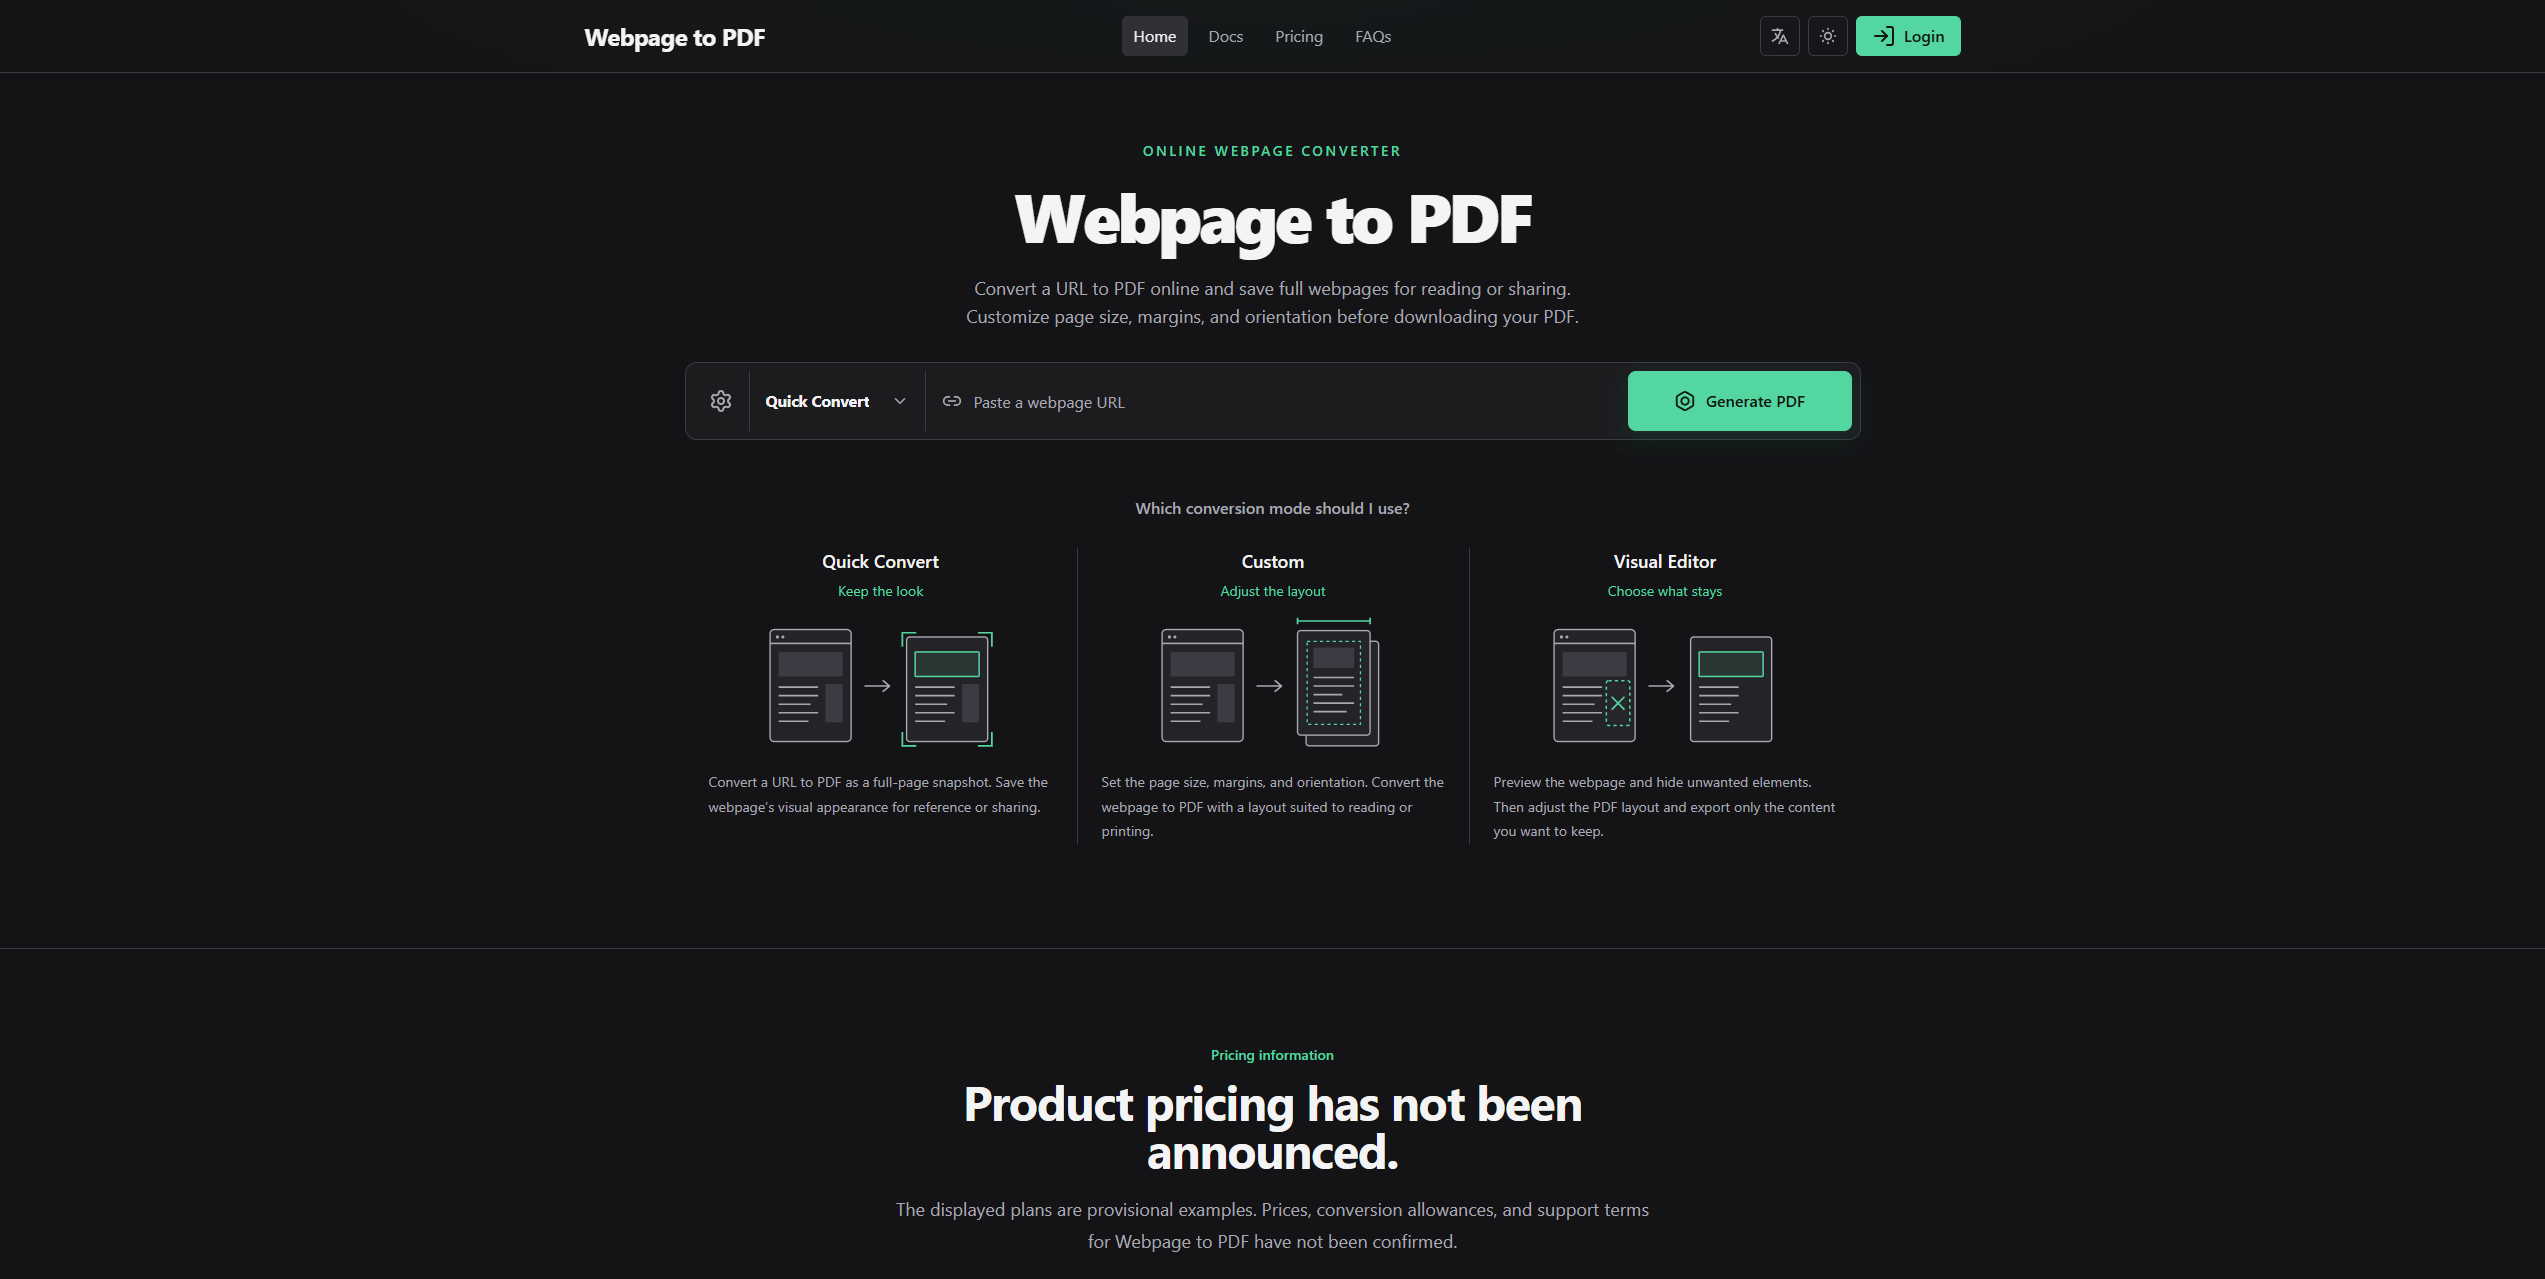
下面是我迁移后的效果图,这是一个精细活,需要慢慢修改解决 bug,不要希望现在的 AI 可以一次性帮你解决所有问题,至少现在还不行:
这一章节没有展开讲太多实现细节,主要有两个原因:
一是原型开发和后续迁移大部分都是通过 AI 完成的,中间经过了很多轮调整和修改,很难把整个过程完整记录下来。
二是这个系列教程的重点一直都是如何使用 Saavo 模板快速开发产品。每个人要做的产品都不一样,具体业务功能的实现方式也会有很大差异,很难整理出一套所有项目都适用的开发流程,因此这部分内容没有必要在教程里展开。
当然,我也可以把 Webpage to PDF 从原型到实现的每个细节都记录下来,但这样会逐渐偏离这个系列教程原本的方向。
相比之下,接下来的内容在 Saavo 模板中更通用,也更值得重点介绍。
本篇检查
完成这一篇后,应能在本地使用三种转换模式,并检查转换接口、下载流程和移动端页面。